混合AI架构落地:本地+云端大模型海外服务器部署实操分享
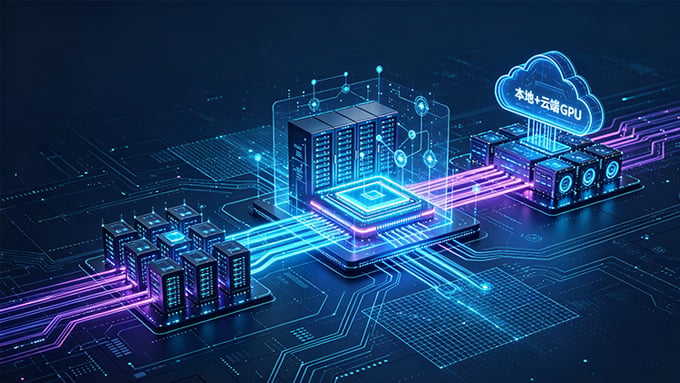
随着大模型出海业务持续增长,很多 AI 团队已经意识到纯本地部署算力不足、并发承载有限,而完全依赖第三方云端 API 又会带来隐私泄露、token 成本持续走高、网络波动等问题。本地 + 云端混合 AI 架构成为当前跨境 AI 项目的优选方案,简单来说就是轻量模型、敏感数据、高频简单推理任务放在本地节点,复杂推理、大参数量模型、流量峰值负载交由云端 GPU 服务器承接。本文结合海外服务器实操经验,完整拆解架构设计、硬件选型、部署流程、网络安全调优,同时结合 RakSmart 海外服务器产品,给出海 AI 开发者一套可直接落地的部署方案。
一、混合 AI 架构核心设计思路
混合架构的核心逻辑是分层任务调度,搭建统一网关路由层作为整个系统的 “请求分诊台”,对用户输入进行意图识别,自动分配任务到本地或云端算力节点。 本地节点主要承载轻量化量化模型,如 7B、13B 量化开源模型,负责意图分类、简单问答、文档摘要、向量检索 RAG 知识库查询等高频低算力消耗任务。这类请求占业务总量 60%~70%,在本地完成推理,不需要将原始业务数据传出节点,保障数据隐私,同时降低云端调用费用。 云端 GPU 节点负责承接复杂逻辑推理、长文本分析、代码生成、多模态任务,以及业务流量突增的峰值请求。当本地 GPU 资源跑满或者路由判定任务复杂度高,请求会自动转发到海外云端大模型集群;云端节点故障时,系统自动降级切回本地模型兜底,保障业务可用性。
针对出海场景,推荐将本地私有节点部署在 RakSmart 裸机云GPU服务器上,物理隔离硬件,搭载 NVMe 高速固态存储私有知识库与模型权重,满足私有化数据管控需求。云端弹性推理节点选用 RakSmart 海外 VPS 和弹性 GPU 实例,分布在洛杉矶、硅谷、东京、新加坡机房,面向全球不同区域用户就近接入,依托精品 CN2 骨干网络,解决跨境访问延迟高、丢包的痛点。
二、海外服务器硬件与机房选型实操
硬件选型是混合架构稳定运行的基础,需要区分本地私有节点与云端弹性节点两套配置。 本地私有化节点,优先选择 RakSmart 裸机 GPU服务器,推荐 A100、RTX 系列 GPU 机型,内存 64GB 起步,搭配大容量 NVMe SSD,用于存储模型文件、向量数据库和业务私有文档。裸机云无虚拟化损耗,支持 IPMI 远程管理,就算是海外机房,国内技术团队也可以远程重装系统、监控硬件状态,适合长期稳定运行私有化模型与向量检索服务。对于中小型团队,前期验证阶段也可以先用 RakSmart 高配置 VPS 做本地节点原型验证,降低项目前期投入。
云端弹性节点,主要用来应对突发流量、运行 70B 等大参数量模型推理,不需要长期独占高性能裸机。RakSmart 弹性 GPU 实例支持按需开通,在业务低谷时释放资源,节省算力开支。面向欧美客户选择硅谷、洛杉矶机房;面向东南亚、日韩用户,东京机房是优选,CN2 线路可以大幅降低国内运维人员远程调试的网络延迟。同时所有机房自带 DDoS 防护,抵御 AI 接口暴露在公网常见的 CC 攻击,保护模型服务稳定。
网络层面,整套架构采用加密隧道打通本地私有节点和云端弹性节点,业务流量走 RakSmart CN2 GIA 精品线路,避免普通国际带宽的网络抖动问题。同时遵循数据就近处理原则,欧洲用户请求在法兰克福节点处理,东南亚用户请求放在新加坡节点,日志就地存储,满足海外不同地区的数据合规要求。
三、分步部署实操流程
3.1 环境准备与系统初始化
服务器操作系统推荐 Ubuntu22.04,在 RakSmart 后台开通实例时,可直接选择预装 CUDA、Docker 的镜像,省去手动部署驱动的大量时间。安装 nvidia-container-toolkit,配置 Docker GPU 运行时,完成宿主机驱动校验,执行nvidia-smi确认显卡识别正常。容器化是混合架构的基础,所有模型服务、向量数据库、网关程序全部打包为容器,方便跨节点迁移、扩容。
3.2 模型部署与量化优化
本地节点部署量化轻量模型,采用 GGUF 量化格式,通过 Ollama 或者 vLLM 部署推理服务,搭建 RAG 向量知识库,把私有业务文档向量化存入向量数据库。云端节点部署完整精度或者半精度大模型,同样使用 vLLM 提升推理吞吐,开启 KV 缓存优化,提升高并发场景下的响应速度。 部署时将模型权重文件提前下载到同机房存储,避免公网反复拉取大文件拖慢启动速度。RakSmart 服务器支持自定义 RAID,可对模型数据集做多副本备份,防止硬件故障丢失权重文件。
3.3 路由网关搭建与分流配置
搭建 API 网关作为统一入口,接入负载均衡,编写路由判断规则。基础规则可以按照请求长度、关键词、用户并发负载判断:短文本、简单查询交给本地模型;长文本深度分析、复杂多步骤任务转发云端 GPU 实例。同时配置熔断策略,云端节点超时、显存占用过高时,自动切换回本地模型降级响应,避免服务整体崩溃。 网关层开启请求日志脱敏,过滤用户隐私信息,在数据出境前完成掩码处理,规避跨境数据合规风险。
3.4 连通性、压测与运维监控
部署完成后,测试本地节点与云端节点加密通道连通性,跨机房调用接口,验证延迟和丢包率。使用压测工具模拟用户并发请求,观测 GPU 显存、CPU、带宽指标,当本地 GPU 负载超过阈值,验证自动扩容云端实例是否正常触发。 监控层面,搭建 Prometheus+Grafana 监控面板,实时采集两台 RakSmart 服务器的 GPU 利用率、推理耗时、接口错误率。利用 RakSmart 后台告警功能,硬件故障、带宽超限、攻击事件第一时间推送通知。
四、架构调优与避坑要点
很多团队落地混合架构时,容易踩网络、显存、成本三类坑。第一,跨境网络问题,不要直接裸端口暴露模型 API,需要搭配域名、SSL 证书,加上 WAF 防护,RakSmart 自带的 DDoS 清洗可以拦截 CC 攻击。第二,显存溢出问题,部署模型预留 20%~25% 显存余量,开启模型分页、量化压缩,避免并发上涨直接 OOM 崩溃。第三,算力成本管控,弹性节点不要长期保持开机,配置自动扩缩容脚本,闲置时自动释放实例。 另外,模型版本管理、权重同步也要做好,本地私有模型更新后,通过内网加密通道同步到各海外节点,不要走公网传输大体积模型文件,既慢又不安全。
五、FAQ常见问题
Q1:混合架构相比纯本地或者纯云端,成本大概能降低多少?
A1:在合理路由分流下,60%~70% 请求由本地模型处理,大幅减少云端 token 开销,综合算力成本通常可下降 30% 以上。RakSmart 裸机服务器适合长期本地私有化推理,弹性 GPU 实例按需启用,进一步控制固定硬件投入。
Q2:海外部署大模型,不同地区机房怎么选?
A2:面向北美用户优先硅谷、洛杉矶机房;日韩、东南亚业务选东京机房;面向欧洲客户选择法兰克福机房。RakSmart 全球多机房搭配 CN2 线路,既保障海外用户访问速度,国内技术人员远程运维延迟更低。
Q3:混合架构的数据安全如何保障,是否符合海外合规?
A3:敏感业务数据在本地裸机节点完成推理,不回传到第三方公网大模型。不同区域用户数据就地存储,网关层自动脱敏个人信息,RakSmart 物理服务器硬件隔离,防止多租户之间数据互相访问,满足海外数据本地化法规。
Q4:新手团队部署,先搭建本地节点还是云端节点?
A4:建议先用 RakSmart VPS 快速搭建本地轻量模型原型,验证业务逻辑和路由规则,完成压测之后,再上线云端弹性 GPU 节点,分步落地,避免一次性投入大量 GPU 算力造成资源闲置。
总结
本地 + 云端混合 AI 架构,很好解决出海 AI 项目在隐私安全、算力弹性、运营成本三者之间的矛盾,不再需要在私有化可控与云端强算力之间二选一。整套方案依托 RakSmart 全球机房、裸机 GPU 服务器、弹性 VPS 和 CN2 精品网络,能够快速完成海外节点部署,通过智能网关实现任务自动分流,敏感数据留在本地私有算力,复杂任务与流量高峰交给云端弹性算力。
在实际落地中,团队需要做好机房地域规划、模型量化优化、跨境网络加密和持续监控,循序渐进完成原型验证、压力测试和生产上线。随着大模型业务迭代,这套架构还可以持续扩展多地域节点,搭建分布式 AI 集群,支撑跨境 AI 产品长期稳定运营。